Anleitung zur Verwendung der Prozesstrennung
Motivation
Vom Anwender bereitgestellter Python-Code (im folgenden „User-Code“) soll aus folgenden Gründen in einem separatem Prozess ausgeführt werden können:
Erhöhung der Stabilität von ecu.test, da Prozesse sich untereinander nicht beeinflussen (bei Programmierfehlern, Bugs in Bibliotheken, Performance- und Speicherproblemen, etc.)
Verwendung von Bibliotheken, die in ecu.test bereits enthalten sind, aber aktualisiert oder angepasst werden müssen, oder die die Laufzeitumgebung oder andere Bibliotheken stark beeinflussen
Bessere Modularisierung durch Trennung von ecu.test-Code und User-Code. Dieses Vorgehen hilft methodisch auch bei der Python 3 Migration weiter.
Verwendung eines anderen Interpreters (z.B. 32-Bit Python, Python 3)
Parallelisierung und Nutzung mehrerer Prozessorkerne
User-Code wird in vielen Bereichen von ecu.test ausgeführt. Die existierenden Erweiterungsschnittstellen verzahnen diesen teils tief mit ecu.test. Deshalb ist es nicht möglich, existierenden Code transparent und automatisiert in getrennte Prozesse auszulagern. Stattdessen gibt es diese Anleitung, mit der User-Code so angepasst oder neu entwickelt werden kann, dass er in einem eigenen Prozess ausgeführt werden kann.
Wann sollte User-Code in einen separaten Prozess ausgelagert werden?
Aus Anwendersicht sollte dieser Schritt immer dann durchgeführt werden, wenn:
Große Datenmengen im Arbeitsspeicher gehalten werden
Alternative Versionen von Python-Bibliotheken verwendet werden, die mit den in ecu.test mitgelieferten Versionen in Konflikt stehen
Eine andere/spezifische Version von Python benötigt wird
Abstürze durch Fehler in verwendeten Bibliotheken oder im User-Code zu befürchten sind
Bei Verwendung von Python-Extensions bzw. C/C++ Bibliotheken, da darin auftretende Fehler/Exceptions von ecu.test nicht erwartet werden und zum Programmabsturz führen können
Architekturübersicht
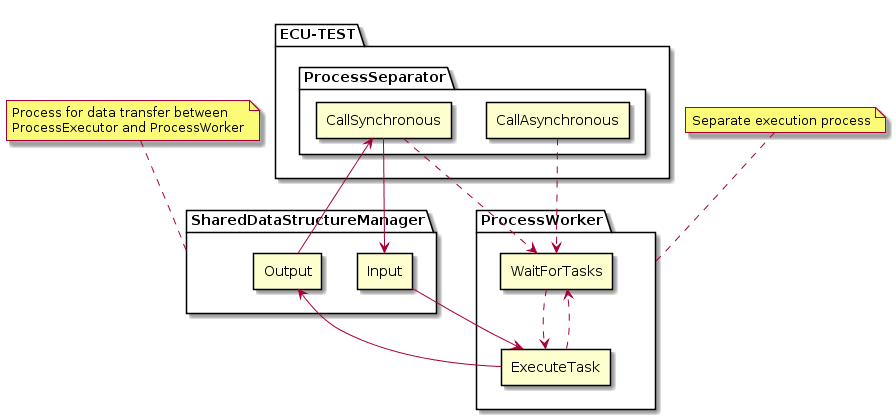
Welche Einschränkungen sind zu beachten?
Zugriff auf Daten im jeweils anderen Prozess ist nicht mehr „einfach so“ möglich, sondern die Daten müssen explizit transferiert werden. Bei großen Datenmengen kann der Datenaustausch extrem viel Zeit und/oder Arbeitsspeicher in Anspruch nehmen. Daher sollte die Trennung zwischen „intern“ und „extern“ ausgeführten Codeteilen so gewählt werden, dass die Menge an auszutauschenden Daten gering bleibt (z.B. nur Parametrierung, Status und Ergebnis, nicht umfangreiche Zwischenergebnisse/Daten).
In ecu.test enthaltene Bibliotheken und Datentypen stehen, wenn ein anderer Interpreter verwendet wird, dem externen Prozess, in dem das Skript ausgeführt wird, nicht zur Verfügung. Daher müssen für den Datenaustausch zwischen ecu.test und dem in einem separaten Prozess ausgeführten User-Code Python-Basisdatentypen verwendet werden.
Die in diesem Beispiel-Workspace mitgelieferte Datei ApiProxy.py ermöglicht einem separat
ausgeführten Prozess Zugriff auf die Internal API von ecu.test.
Weiterhin können z.B. die COM API und die
Object API verwendet werden.
Info
Das über die ApiProxy.py zur Verfügung gestellte API bietet nicht die vollständige
Funktionalität des Internal API von ecu.test. Die Python
Bibliothek xmlrpc, welche zur Bereitstellung der ApiProxy Schnitstelle verwendet wird,
erlaubt beispielsweise ausschließlich Strings für die Keys eines Python Dictionaries. Für
manche BusBrowser-Methoden gibt es den optionalen Parameter numbersAsStrings um dieses
Problem zu umgehen.
Vorgehen zur Umstellung
Um bestehenden Nutzer-Code auf die Prozesstrennung umzustellen, muss wie folgt vorgegangen werden:
Trennstellen identifizieren bzw. schaffen:
Welche Code-Bestandteile sollen im eigenen Prozess laufen, welche im ecu.test-Prozess?
Was im eigenen Prozess laufen soll muss eine eigene Funktion bzw. Methode sein (kein Codeabschnitt innerhalb einer größeren Funktion/Methode)
Parameter und Rückgabewerte der Funktionen sollen möglichst kleine Objekte sein und nur folgende Typen verwenden:
Basisdatentypen: int, float, str, unicode, NoneType
Aggregationen: list, set, tuple, dict
beliebig tief geschachtelt
keine selbstgeschriebenen Klassen und keine ecu.test-Datentypen (Map, Curve, Matrix, ByteStream etc.)
durch Tupel oder Dictionaries, die die relevanten Attribute enthalten, ersetzen
keine Klassen aus Bibliotheken
falls Tupel oder Dictionaries mit den relevanten Attributen nicht möglich sind, ggf.
pickleverwenden, um Objekte in Strings und zurück umzuwandeln.
Das
UserProcess-Package zumPYTHONPATHhinzufügenIn den ecu.test-Einstellungen unter Python-Bibliotheken falls noch nicht konfiguriert einen initial leeren Ordner angeben
den Ordner
UserProcessin den dort angegebenen Ordner kopierenggf. die Datei
ApiProxy.pyebenfalls dorthin kopieren
Den Programmcode, der in einem eigenen Prozess laufen soll, in eine eigene
*.py-Datei verschieben.Er darf nicht direkt in einer Function-Variable, einem UserPyModule, oder einem Report- bzw. Projekt-/Package-/Parametersatz-Generator, UserUtility oder User-Tooladapter stehen, sondern davon getrennt in einer (oder mehreren) eigenen
*.py-Datei(en).Dort, wo der Programmcode früher direkt aufgerufen wurde, eine
ProcessSeparator-Instanz erzeugen undCallAsynchronousbzw.CallSynchronousverwenden (analog den Beispielen inProcessDataInOtherProcess.pyoderTwoSubProcessesWithFunctionVariable.pkg)Je nachdem, ob der separate Prozess im in ecu.test integrierten Python-Interpreter ausgeführt werden soll, oder in einem eigenen, dem
ProcessSeparator-Konstruktor einen Pfad zur gewünschten :file:python.exeübergeben. Defaultwert istNonefür Ausführung im ecu.test-Interpreter.Info
Damit ein eigener Python-Interpreter verwendet werden kann, muss in dessen Umgebung die Bibliothek tblib installiert sein.
Falls in dem Modul bzw. den Modulen, das/die im eigenen Prozess ausgeführt werden soll(en) auf die interne API zugegriffen wird, folgenden Python-Code hinzufügen:
from ApiProxy import ApiProxy
api = ApiProxy()
Nach diesen zwei Zeilen kann
api.*„ganz normal“ benutzt werden, wie innerhalb von ecu.test.Zugriff auf die the COM API und Object API erfordert dagegen keine besonderen Maßnahmen. Zugriff auf sonstige ecu.test-APIs (z.B. Report API) ist nicht möglich bzw. muss in dem Codeteil erfolgen, der nicht im separaten Prozess läuft.
Falls in einer asynchron aufzurufenden Funktion Exceptions erwartet werden, kann diese optional wie folgt erweitert werden, damit die Fehler nicht komplett unbemerkt bleiben:
def myFunction(...):
    try:
        # original implementation of the function

    except Exception:
        import traceback
        traceback.print_exc()
Dadurch wird eine evtl. in der Funktion auftretende Exception wenigstens in
ECU_TEST_ERR.logprotokolliert, statt komplett ignoriert zu werden. Bei synchroner Ausführung wird die Exception an den Aufrufer durchgereicht. Daher ist diese Behandlung nicht erforderlich.
Beispiele
Der Beispielworkspace enthält Packages und Python-Code um die Verwendung zu veranschaulichen.