Lesen und Vergleichen von Audioaufnahmen
Dieser Dialog wird angezeigt, wenn Sie aus dem Medienzugriff-Tab einen Lesen-Testschritt für ein Audio-Gerät oder einen Audio-Kanal zum Testfall hinzufügen.
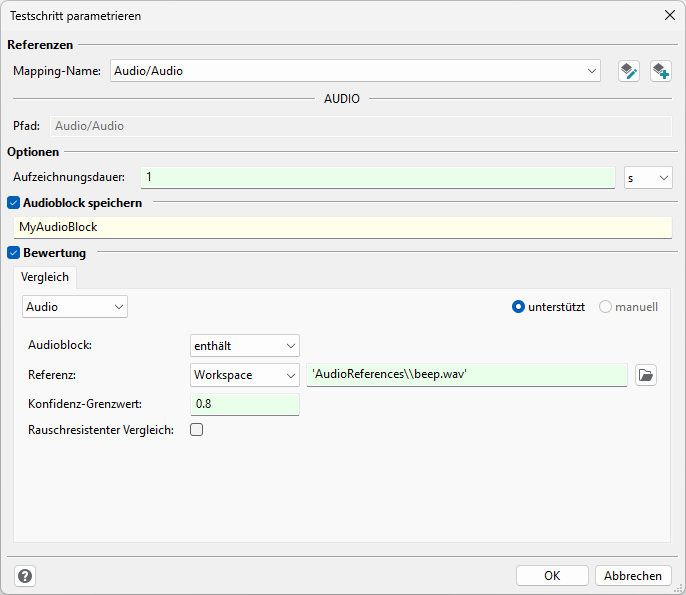
Der Dialog ist in vier Sektionen gegliedert:
Referenz
Hier kann das referenzierte Mapping-Item angegeben oder verändert werden.
Optionen
In diesem Bereich kann angegeben werden, wie lange das Audiosignal für diesen Testschritt aufgezeichnet werden soll.
Audioblock speichern
Optional kann ein der Name einer Testfallvariable angegeben werden. Die Audio-Aufzeichnung wird dann in dieser Variablen als AudioBlock gespeichert.
Bewertung
Hier kann der Erwartungswert definiert werden. Es gibt zwei unterschiedliche Typen von Erwartungswerten. Diese Typen können in dem Dropdown-Menü oben links im Tab „Vergleich“ ausgewählt werden.
Erwartungstyp Audio
Die gelesene Aufnahme wird mit einer Referenzaufnahmen verglichen. Es kann über Audioblock: ausgewählt werden, ob die Referenzaufnahme gemäß dem Vergleichsalgorithmus in der Aufnahme enthalten sein muss oder nicht enthalten sein darf.
Es sind folgende Typen von Referenzaufnahmen zulässig:
Referenz-Typ |
Zulässige Ausdrücke |
Beispiele |
|---|---|---|
Objekt |
|
|
Workspace |
Pfad zu einer Datei im Workspace als String. Es können Dateien vom Typ WAV, FLAC, MP3, OGG oder weiteren von der Python-Bibliothek „soundfile“ unterstützten Datentypen angegeben werden. |
|
Des Weiteren kann der Vergleichsalgorithmus parametriert werden:
Konfidenz-Grenzwert: Hier kann angegeben werden, mit welcher Konfidenz die Referenz in der Aufnahme erkannt worden sein muss. Der Wert liegt zwischen 0 und 1. Erkennt der zugrunde liegende Vergleichsalgorithmus beispielsweise eine Referenzaufnahme mit einer Konfidenz von 0.7, so gilt sie bei einem Konfidenz-Grenzwert von 0.8 dennoch als nicht enthalten.
Rauschresistenter Vergleich: Handelt es sich um verrauschte Aufnahmen, kann über diese Einstellung die Erkennung verbessert werden. Für Aufnahmen ohne Rauschen wird empfohlen, den rauschresistenten Vergleich nicht zu wählen.
Erwartungstyp String
Mittels Spracherkennung kann in einer Audioaufnahme gesprochener Text erkannt und mit dem Erwartungswert verglichen werden. Der dafür verwendete Speech-to-Text-Service kann in der Testkonfiguration. ausgewählt werden. Es ist möglich, eigene Speech-to-Text-Services anzubinden. Diese werden dann ebenfalls in der Testkonfiguration aufgelistet. Genauere Informationen befinden sich in der Hilfe-Sektion unter Nutzerdefinierte Spracherkennung.
Erwartungstyp Unspecific
Hier kann der Erwartungswert direkt angegeben werden. „value“ stellt hierbei ein AudioBlock-Objekt dar. Die Schnittstelle des AudioBlock-Objekts ist in der AudioBlock hinterlegt.