Tab Medienzugriff
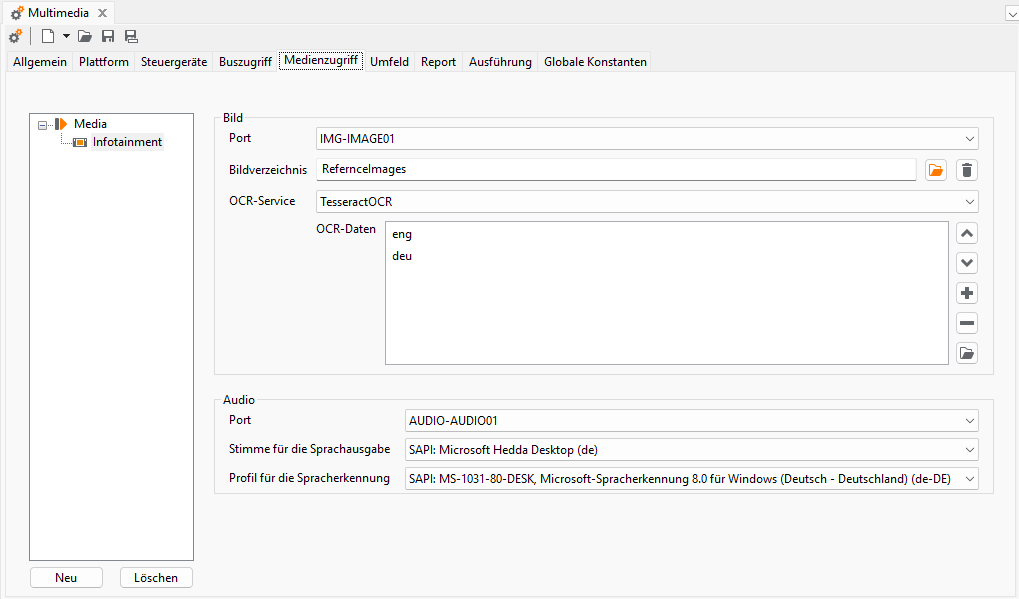
Unterhalb des Tabs Medienzugriff können ein oder mehrere Systeme für Medienzugriffe angelegt werden. Sie werden mit einem Symbol eines Infotainment-Bildschirms dargestellt. Die benötigen Ports müssen zuvor in der Testbenchkonfiguration angelegt werden. Beispielsweise verfügt das Tool tracetronic: Multimedia über Image- und Audio-Ports. Anschließend muss die Testbenchkonfiguration ausgewählt werden. Jedem Multimedia-System kann ein Bild- und ein Audio-Port zuordnet werden.
Bild
Unter Port kann ein in der geladenen Testbenchkonfiguration vorhandener Image-Port ausgewählt werden, beispielsweise ein Image-Port der Toolanbindung tracetronic: Multimedia.
Unter Bildverzeichnis muss das Basisverzeichnis angegeben werden, in dem Referenzbilder und Masken zu finden. Diese stehen nach dem Starten der Konfiguration im Tab des Aktionsfensters zur Verfügung. Der Pfad des Bild-Ordners wird relativ zu dem „Images“-Verzeichnis des Workspaces angegeben. Hinweise zum Erstellen von Masken erhalten Sie hier.
ecu.test bietet die Möglichkeit, Textinhalte von Bildern auszulesen und im Testfall zu verarbeiten. Standardmäßig wird hierfür das Framework Tesseract OCR verwendet, welches Trainingsdaten zur Erkennung von Texten in bestimmten Sprachen und Fonts voraussetzt. Dabei können Trainingsdaten verschiedener Sprachen und Fonts kombiniert werden. Für eine detaillierte Erklärung zu diesem Thema empfehlen wir die entsprechende Dokumentation von Tesseract OCR.
Welche Trainingsdaten in welcher Reihenfolge zu applizieren sind, muss im Feld OCR-Daten konfiguriert werden. ecu.test liefert standardmäßig einige Trainigsdaten aus, die unter https://github.com/tesseract-ocr/tessdata_fast zu finden sind.
Info
Die Trainingsdaten von https://github.com/tesseract-ocr/tessdata_fast priorisieren Performance über Genauigkeit. Sollte die Genauigkeit der Texterkennung unzureichend sein, kann es eventuell helfen, Trainingsdaten von https://github.com/tesseract-ocr/tessdata bzw. https://github.com/tesseract-ocr/tessdata_best zu verwenden.
Um eigene Testdaten zu verwenden, müssen diese entweder im Verzeichnis res/tessdata im Installationsverzeichnis von ecu.test abgelegt oder über den Button Eigene OCR-Daten vom Dateisystem auswählen angegeben werden.
Info
Bei Tesseract OCR ist die Reihenfolge relevant, in der die Trainingsdaten geladen werden. Dadurch haben die Trainingsdaten eine unterschiedliche Relevanz bei der Texterkennung und verschiedene Reihenfolgen können zu verschiedenen Ergebnissen führen. Diese Reihenfolge ist im TCF-Editor durch die Liste der Daten repräsentiert, wobei der oberste Eintrag die höchste und der unterste die niedrigste Priorität bekommt.
Zusätzlich besteht die Möglichkeit, einen eigenen Dienst zur Texterkennung per UserPyModules zu integrieren. Bei erfolgreicher Implementierung kann dieser als benutzerdefinierter OCR-Service im entsprechenden Dropdown ausgewählt werden.
Audio
Unter Port kann ein Audio-Port ausgewählt werden, beispielsweise ein Audio-Port der Toolanbindung tracetronic: Multimedia. Für die Sprachausgabe kann eine Default-Stimme und für die Spracherkennung ein Default-Profil ausgewählt werden. Es besteht zudem die Möglichkeit der Erweiterung mittels eine benutzerdefnierte Stimme bzw. Spracherkennung (siehe Benutzerdefinierte Sprachausgabe und Benutzerdefinierte Spracherkennung).